 播面
Data Parallel (DP) 和 Distributed Data Parallel (DDP) 的区别
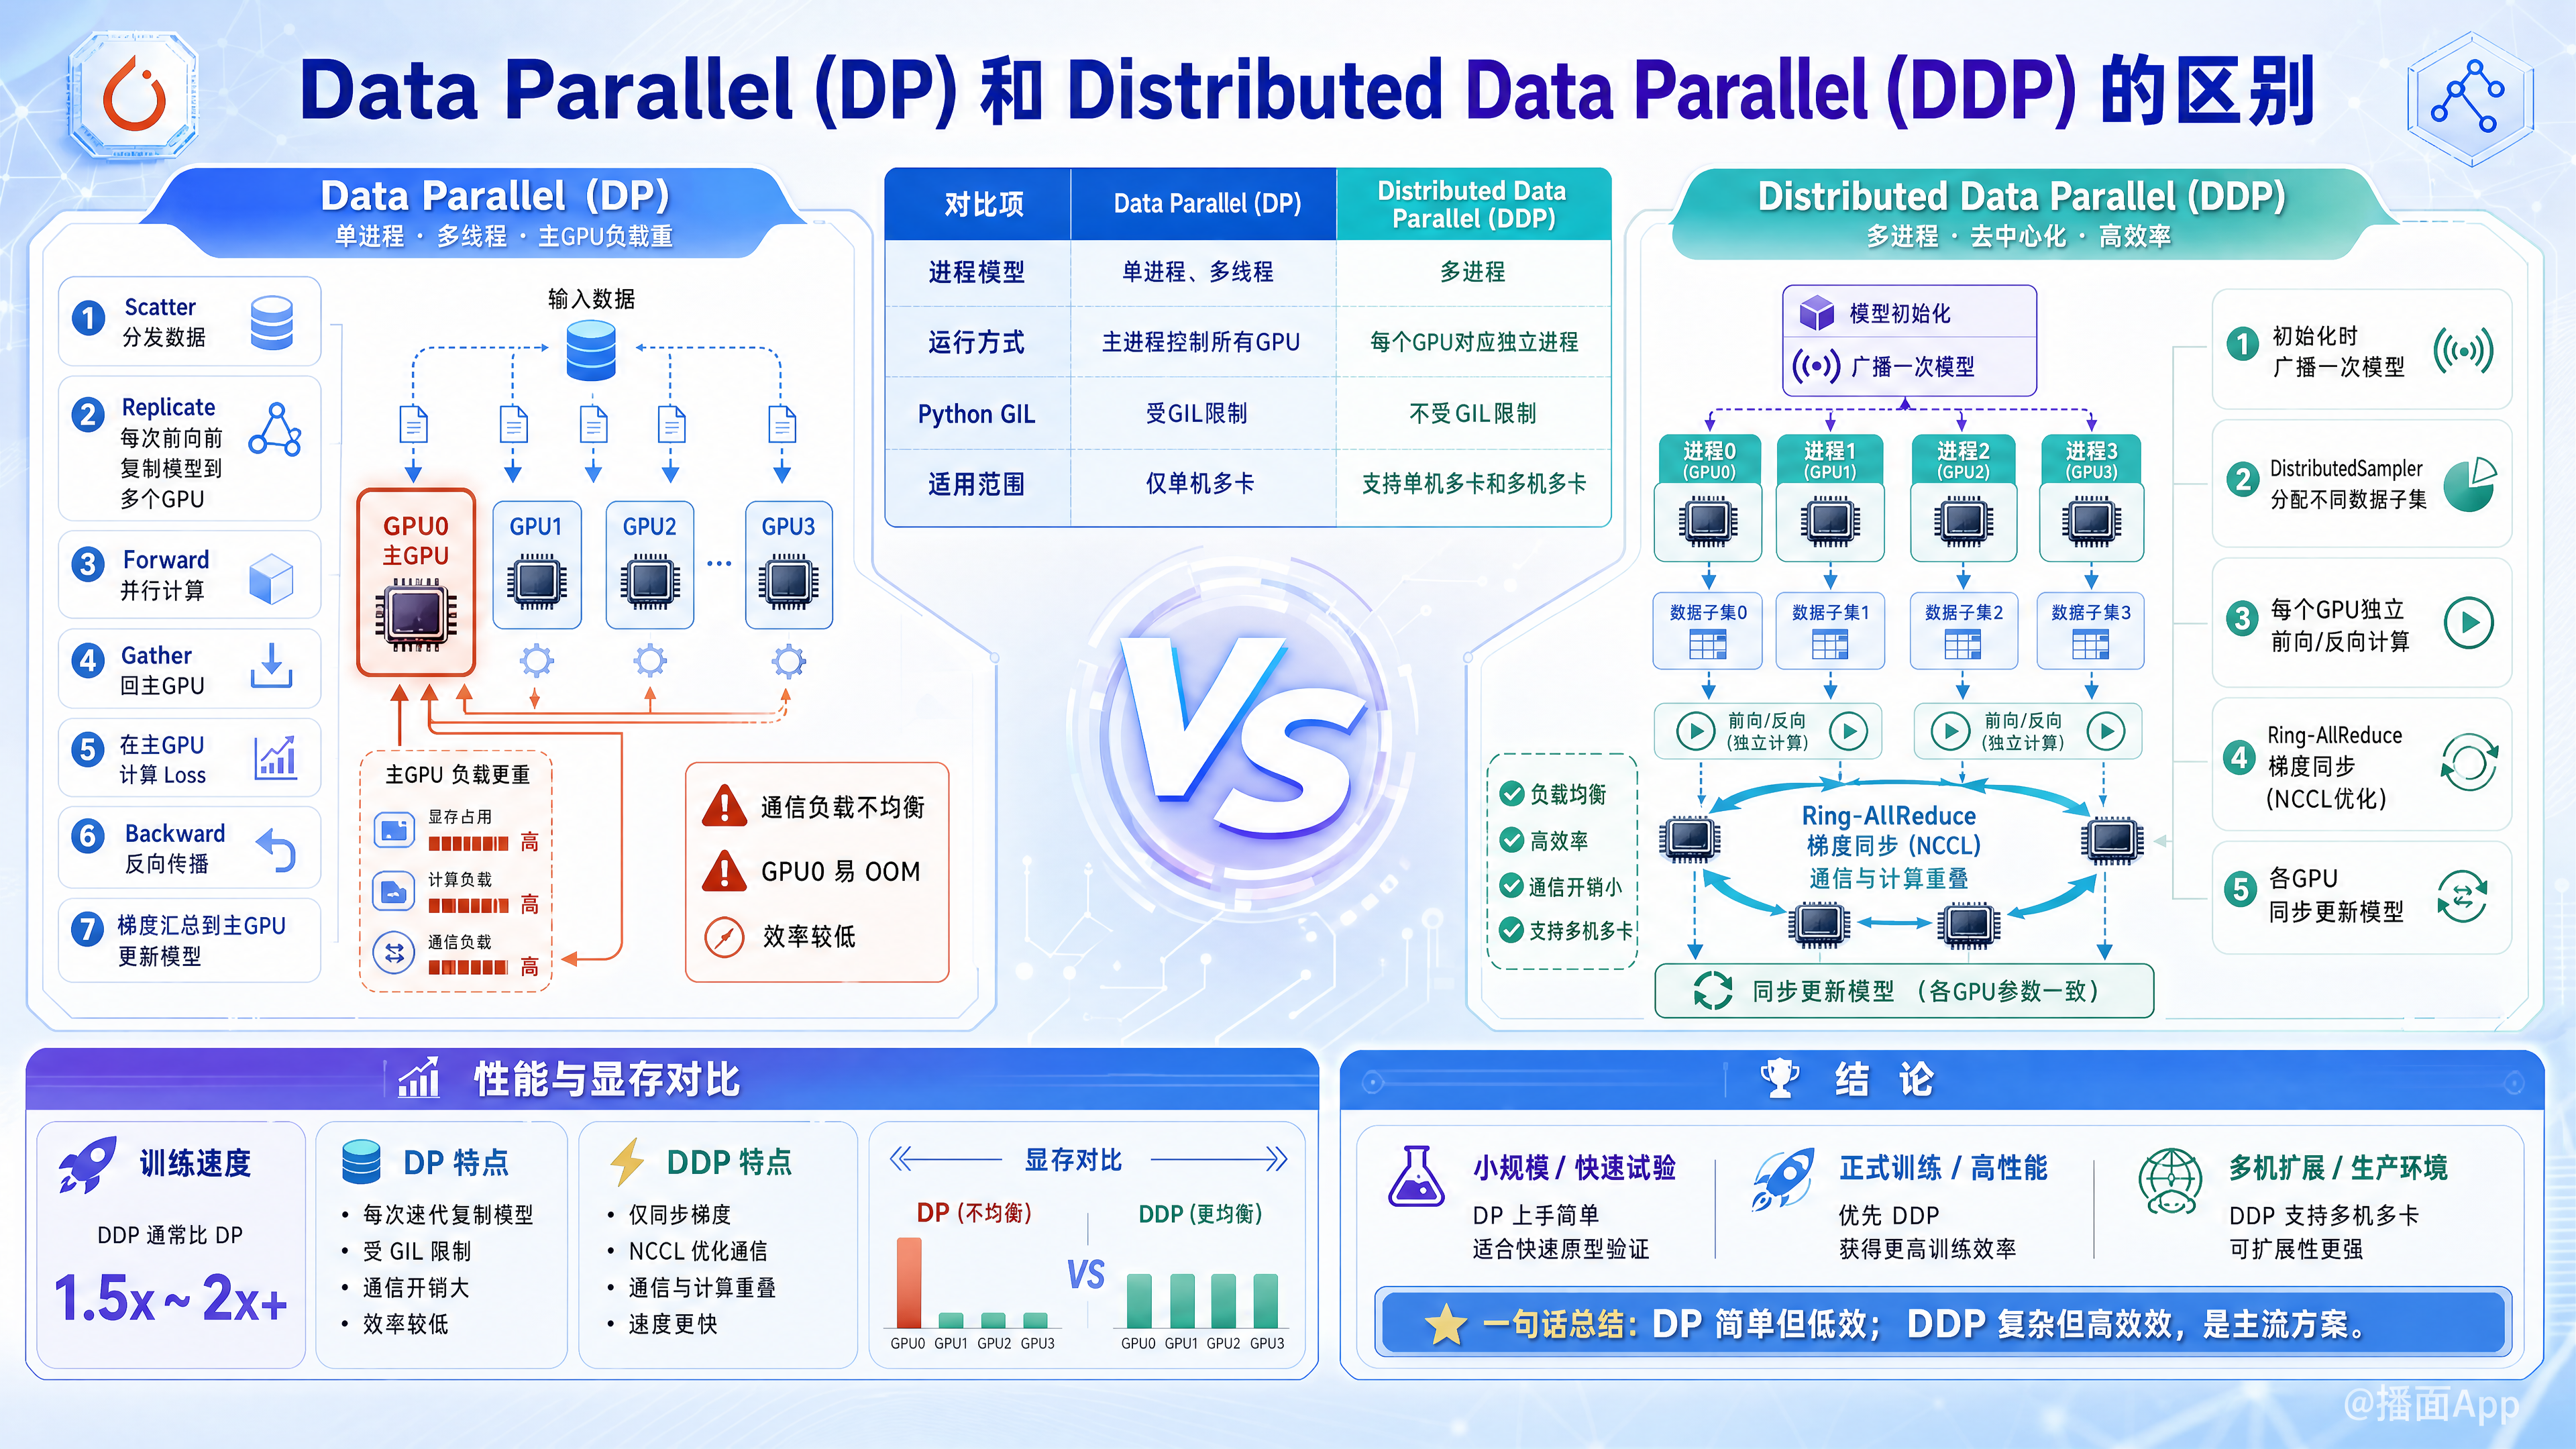
在深度学习(特别是 PyTorch)中,DP (Data Parallel) 和 DDP (Distributed Data Parallel) 是两种常见的多 GPU 训练加速方法。
简单来说:DP 是旧的、简单的、但在大规模训练中效率较低的方案;DDP 是新的、复杂的、但效率极高且支持多机的方案。
以下是它们的详细区别对比:
1. 核心架构与进程模型
| 特性 | Data Parallel (DP) | Distributed Data Parallel (DDP) |
|---|---|---|
| 进程模型 | 单进程,多线程 (Single-Process, Multi-Thread) | 多进程 (Multi-Process) |
| 运行方式 | 主进程控制所有 GPU,利用多线程分发任务。 | 每个 GPU 对应一个独立的进程,进程间通过通信库同步。 |
| Python GIL | 受限制。Python 的全局解释器锁 (GIL) 会限制多线程的并行效率。 | 无限制。每个进程有独立的 Python 解释器,完全绕过 GIL。 |
| 适用范围 | 仅限 单机多卡。 | 支持 单机多卡 和 多机多卡。 |
2. 工作原理与通信机制
Data Parallel (DP) —— "参数服务器"模式 (Parameter Server 变体)
DP 的工作流程非常依赖于 "主 GPU" (通常是 GPU 0):
- 分发 (Scatter): 将一个 Batch 的数据切分,分发到各个 GPU。
- 复制 (Replicate): 在每次前向传播前,将主 GPU 上的模型权重复制到所有其他 GPU(这是巨大的开销)。
- 前向 (Forward): 各 GPU 并行计算输出。
- 收集 (Gather): 将所有 GPU 的输出收集回主 GPU。
- 计算 Loss: 在主 GPU 上计算 Loss。
- 反向 (Backward): Loss 反传,各 GPU 计算梯度。
- 梯度汇总: 将所有梯度汇总到主 GPU,更新权重。
- 缺点: 通信负载不均衡。主 GPU 承担了汇总输出、计算 Loss、更新权重、分发模型的所有工作,导致主 GPU 显存占用高、利用率高,而其他 GPU 等待时间长。
Distributed Data Parallel (DDP) —— "Ring-AllReduce" 模式
DDP 采用去中心化的方式:
- 初始化: 模型在开始时广播一次,之后每个 GPU 维护自己的模型副本。
- 数据采样: 使用
DistributedSampler确保每个进程读取不同的数据子集。 - 独立计算: 每个 GPU 独立进行前向传播和反向传播。
- 梯度同步 (Ring-AllReduce): 在反向传播计算梯度的同时,通过高效的环状通信算法(Ring-AllReduce)在所有 GPU 间同步梯度的平均值。
- 同步更新: 每个 GPU 使用同步后的梯度独立更新自己的模型权重(因为初始权重一样,梯度一样,更新后的权重也自然一样)。
- 优点: 负载均衡。没有主 GPU,所有 GPU 工作量一致。通信和计算重叠(Overlap),效率极高。
3. 性能与显存对比
- 训练速度:
- DDP 快得多。通常比 DP 快 1.5倍 到 2倍甚至更多。
- DP 每次迭代都要复制模型,且受 GIL 限制,通信开销大。
- DDP 仅同步梯度,且利用 NCCL 库进行底层优化。
- 显存占用:
- DP 极不均衡。GPU 0 经常先爆显存(OOM),而其他 GPU 还有大量空闲。
- DDP 均衡。每个 GPU 占用基本一致。
4. 代码实现复杂度
Data Parallel (DP)
非常简单,通常只需要一行代码:
python
model = nn.DataParallel(model) # 只需要这一行
output = model(input)
Distributed Data Parallel (DDP)
比较复杂,需要处理进程组、采样器和启动方式:
- 初始化进程组:
dist.init_process_group(...) - 包装模型:
model = DDP(model, device_ids=[local_rank]) - 数据采样: 需要使用
DistributedSampler(dataset)并在 DataLoader 中指定。 - 启动: 不能直接
python train.py,通常需要使用torchrun或torch.distributed.launch。
总结:该选哪个?
95% 的情况:请使用 DDP。
- 即使是单机多卡,DDP 也比 DP 快很多,且显存管理更好。
- PyTorch 官方文档明确建议使用 DDP。
5% 的情况:可以使用 DP。
- 代码极其简单,不想改动代码结构。
- 模型很小,数据量很小,且处于调试阶段(Quick & Dirty)。
- 由于某些特殊原因无法使用多进程(例如某些复杂的数据加载逻辑在多进程下会死锁)。
一句话总结:DP 是“主从模式”,简单但有瓶颈;DDP 是“合作模式”,复杂但高效且可扩展。