 播面
什么是 SparkContext 和 SparkSession?
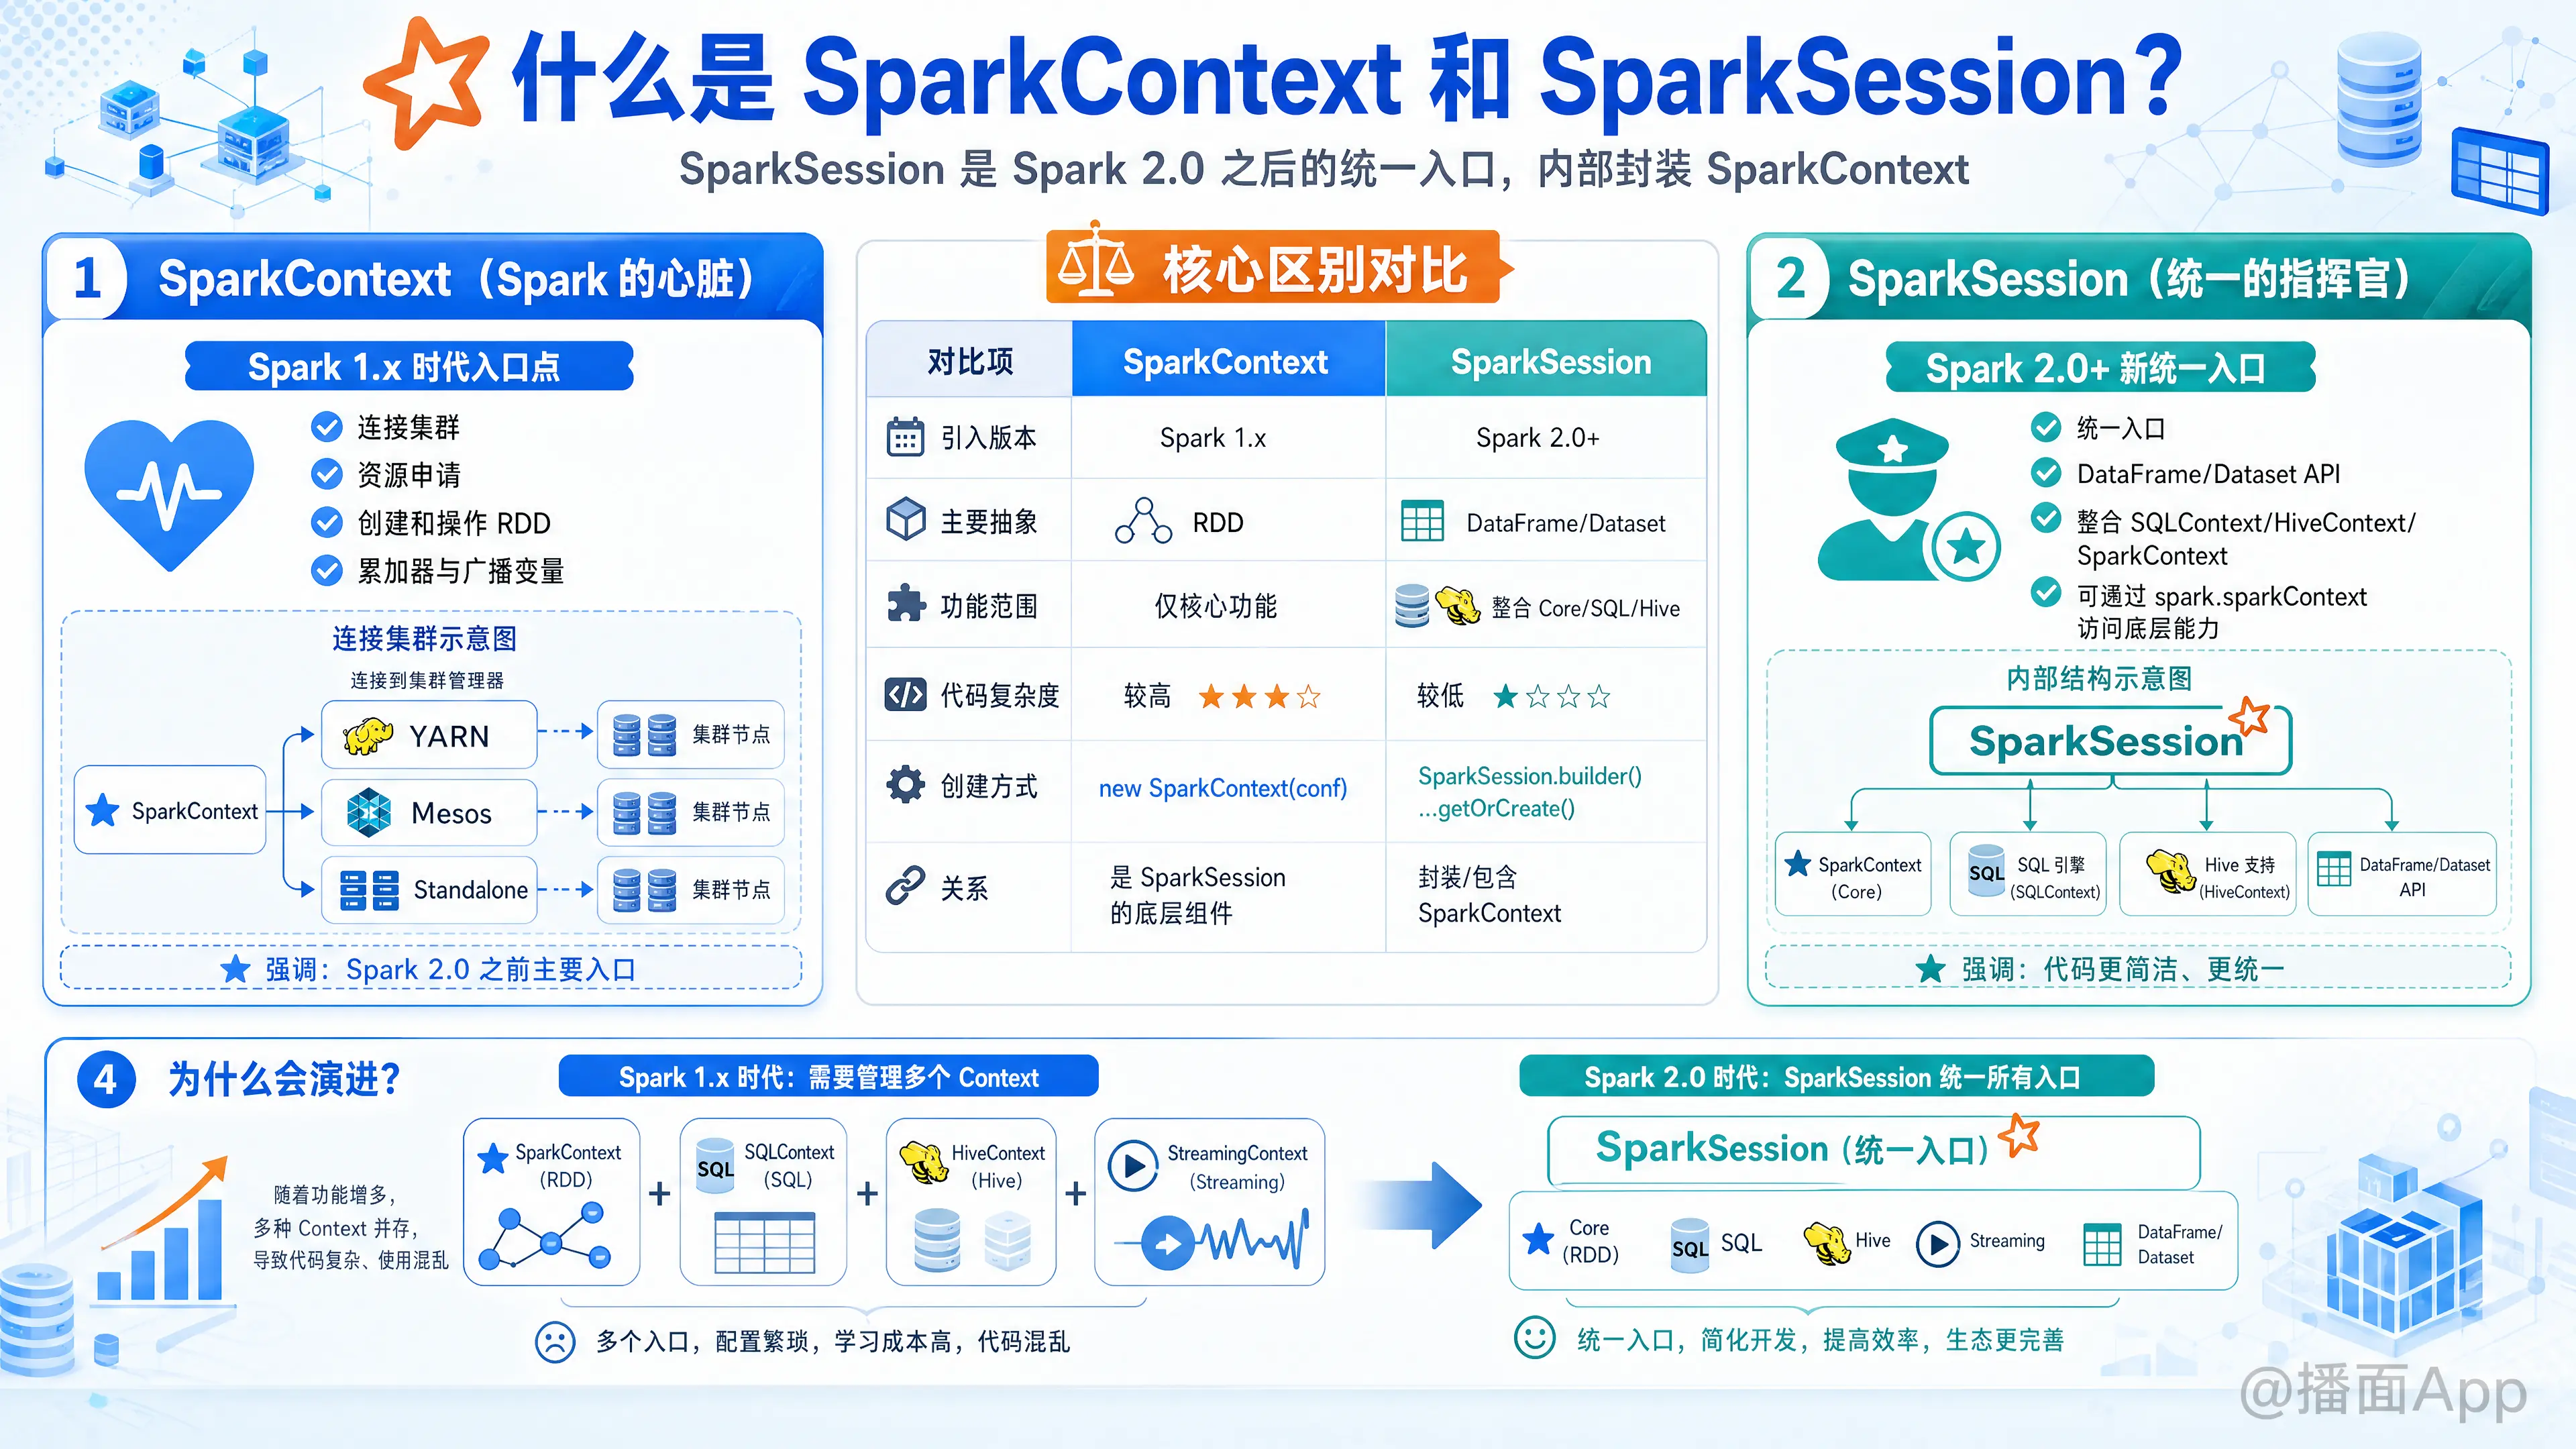
SparkContext 和 SparkSession 都是 Apache Spark 应用程序的入口点(Entry Points),但它们分别代表了 Spark 发展的两个不同阶段。
简单来说:SparkSession 是 Spark 2.0 之后引入的新的、统一的入口点,它封装了 SparkContext,使得编写 Spark 代码更加简洁和统一。
以下是详细的解释和对比:
1. SparkContext (Spark 的心脏)
历史地位:
在 Spark 2.0 之前(Spark 1.x),SparkContext 是所有 Spark 功能的主要入口点。
主要功能:
- 连接集群: 它负责连接到集群管理器(如 YARN、Mesos 或 Standalone)。
- 资源申请: 它告诉集群管理器需要多少 CPU 和内存。
- 创建 RDD: 它是创建和操作 RDD(弹性分布式数据集)的主要方式。
- 累加器和广播变量: 用于创建和管理这些共享变量。
痛点(为什么要改变):
在 Spark 1.x 时代,如果你想使用不同的功能,你需要创建不同的 Context 对象:
- 使用核心功能(RDD) ->
SparkContext - 使用 SQL 查询 ->
SQLContext - 使用 Hive 功能 ->
HiveContext - 使用流处理 ->
StreamingContext
这导致代码变得混乱,开发者需要管理多个 Context 对象。
2. SparkSession (统一的指挥官)
历史地位:
Spark 2.0 引入了 SparkSession。它是为了简化 API 并统一 Spark 的各种功能而设计的。
主要功能:
- 统一入口: 它实质上是
SQLContext、HiveContext和SparkContext的组合。 - DataFrame/Dataset API: 它是使用 DataFrame 和 Dataset API 的入口。
- 内部封装:
SparkSession内部包含了一个SparkContext。如果你需要使用底层的 RDD 功能,你仍然可以通过SparkSession访问到SparkContext(通常通过spark.sparkContext调用)。
优势:
你不再需要区分 SQLContext 或 HiveContext。无论你是想写 SQL、读取 Parquet 文件、连接 Hive 元存储,还是创建 DataFrame,只需要一个 SparkSession 对象即可。
3. 核心区别对比表
| 特性 | SparkContext | SparkSession |
|---|---|---|
| 引入版本 | Spark 1.x (一直存在) | Spark 2.0+ |
| 主要抽象 | RDD (Resilient Distributed Dataset) | DataFrame 和 Dataset |
| 功能范围 | 仅核心 Spark 功能 (Core) | 整合了 Core, SQL, Hive 等功能 |
| 代码复杂度 | 较高 (需管理多个 Context) | 较低 (统一接口) |
| 创建方式 | new SparkContext(conf) |
SparkSession.builder()...getOrCreate() |
| 关系 | 它是 SparkSession 的底层组件 | 它封装/包含了 SparkContext |
4. 代码示例对比
旧方式 (Spark 1.x 风格) - 使用 SparkContext
你需要分别创建 Context 来处理不同的任务:
plaintext
// 1. 配置
val conf = new SparkConf().setAppName("OldStyle").setMaster("local")

// 2. 创建 SparkContext (用于 RDD)
val sc = new SparkContext(conf)

// 3. 如果要用 SQL,还需要创建 SQLContext
val sqlContext = new org.apache.spark.sql.SQLContext(sc)

// 使用 RDD
val rdd = sc.textFile("data.txt")
新方式 (Spark 2.0+ 风格) - 使用 SparkSession
只需要创建一个对象:
plaintext
import org.apache.spark.sql.SparkSession

// 1. 使用 Builder 模式创建 SparkSession
val spark = SparkSession.builder()
    .appName("NewStyle")
    .master("local")
    .enableHiveSupport() // 如果需要 Hive 支持,直接链式调用即可
    .getOrCreate()

// 2. 使用 DataFrame (推荐)
val df = spark.read.text("data.txt")

// 3. 如果你真的非常需要 RDD,也可以通过 spark 拿到 sc
val rdd = spark.sparkContext.textFile("data.txt")
总结
- 如果你在使用 Spark 2.0 或更高版本(现在绝大多数情况都是),你应该始终使用
SparkSession作为程序的入口。 SparkContext并没有消失,它仍然在底层工作,作为连接集群的核心组件,但被SparkSession完美地包装起来了。