Flink双流Join原理
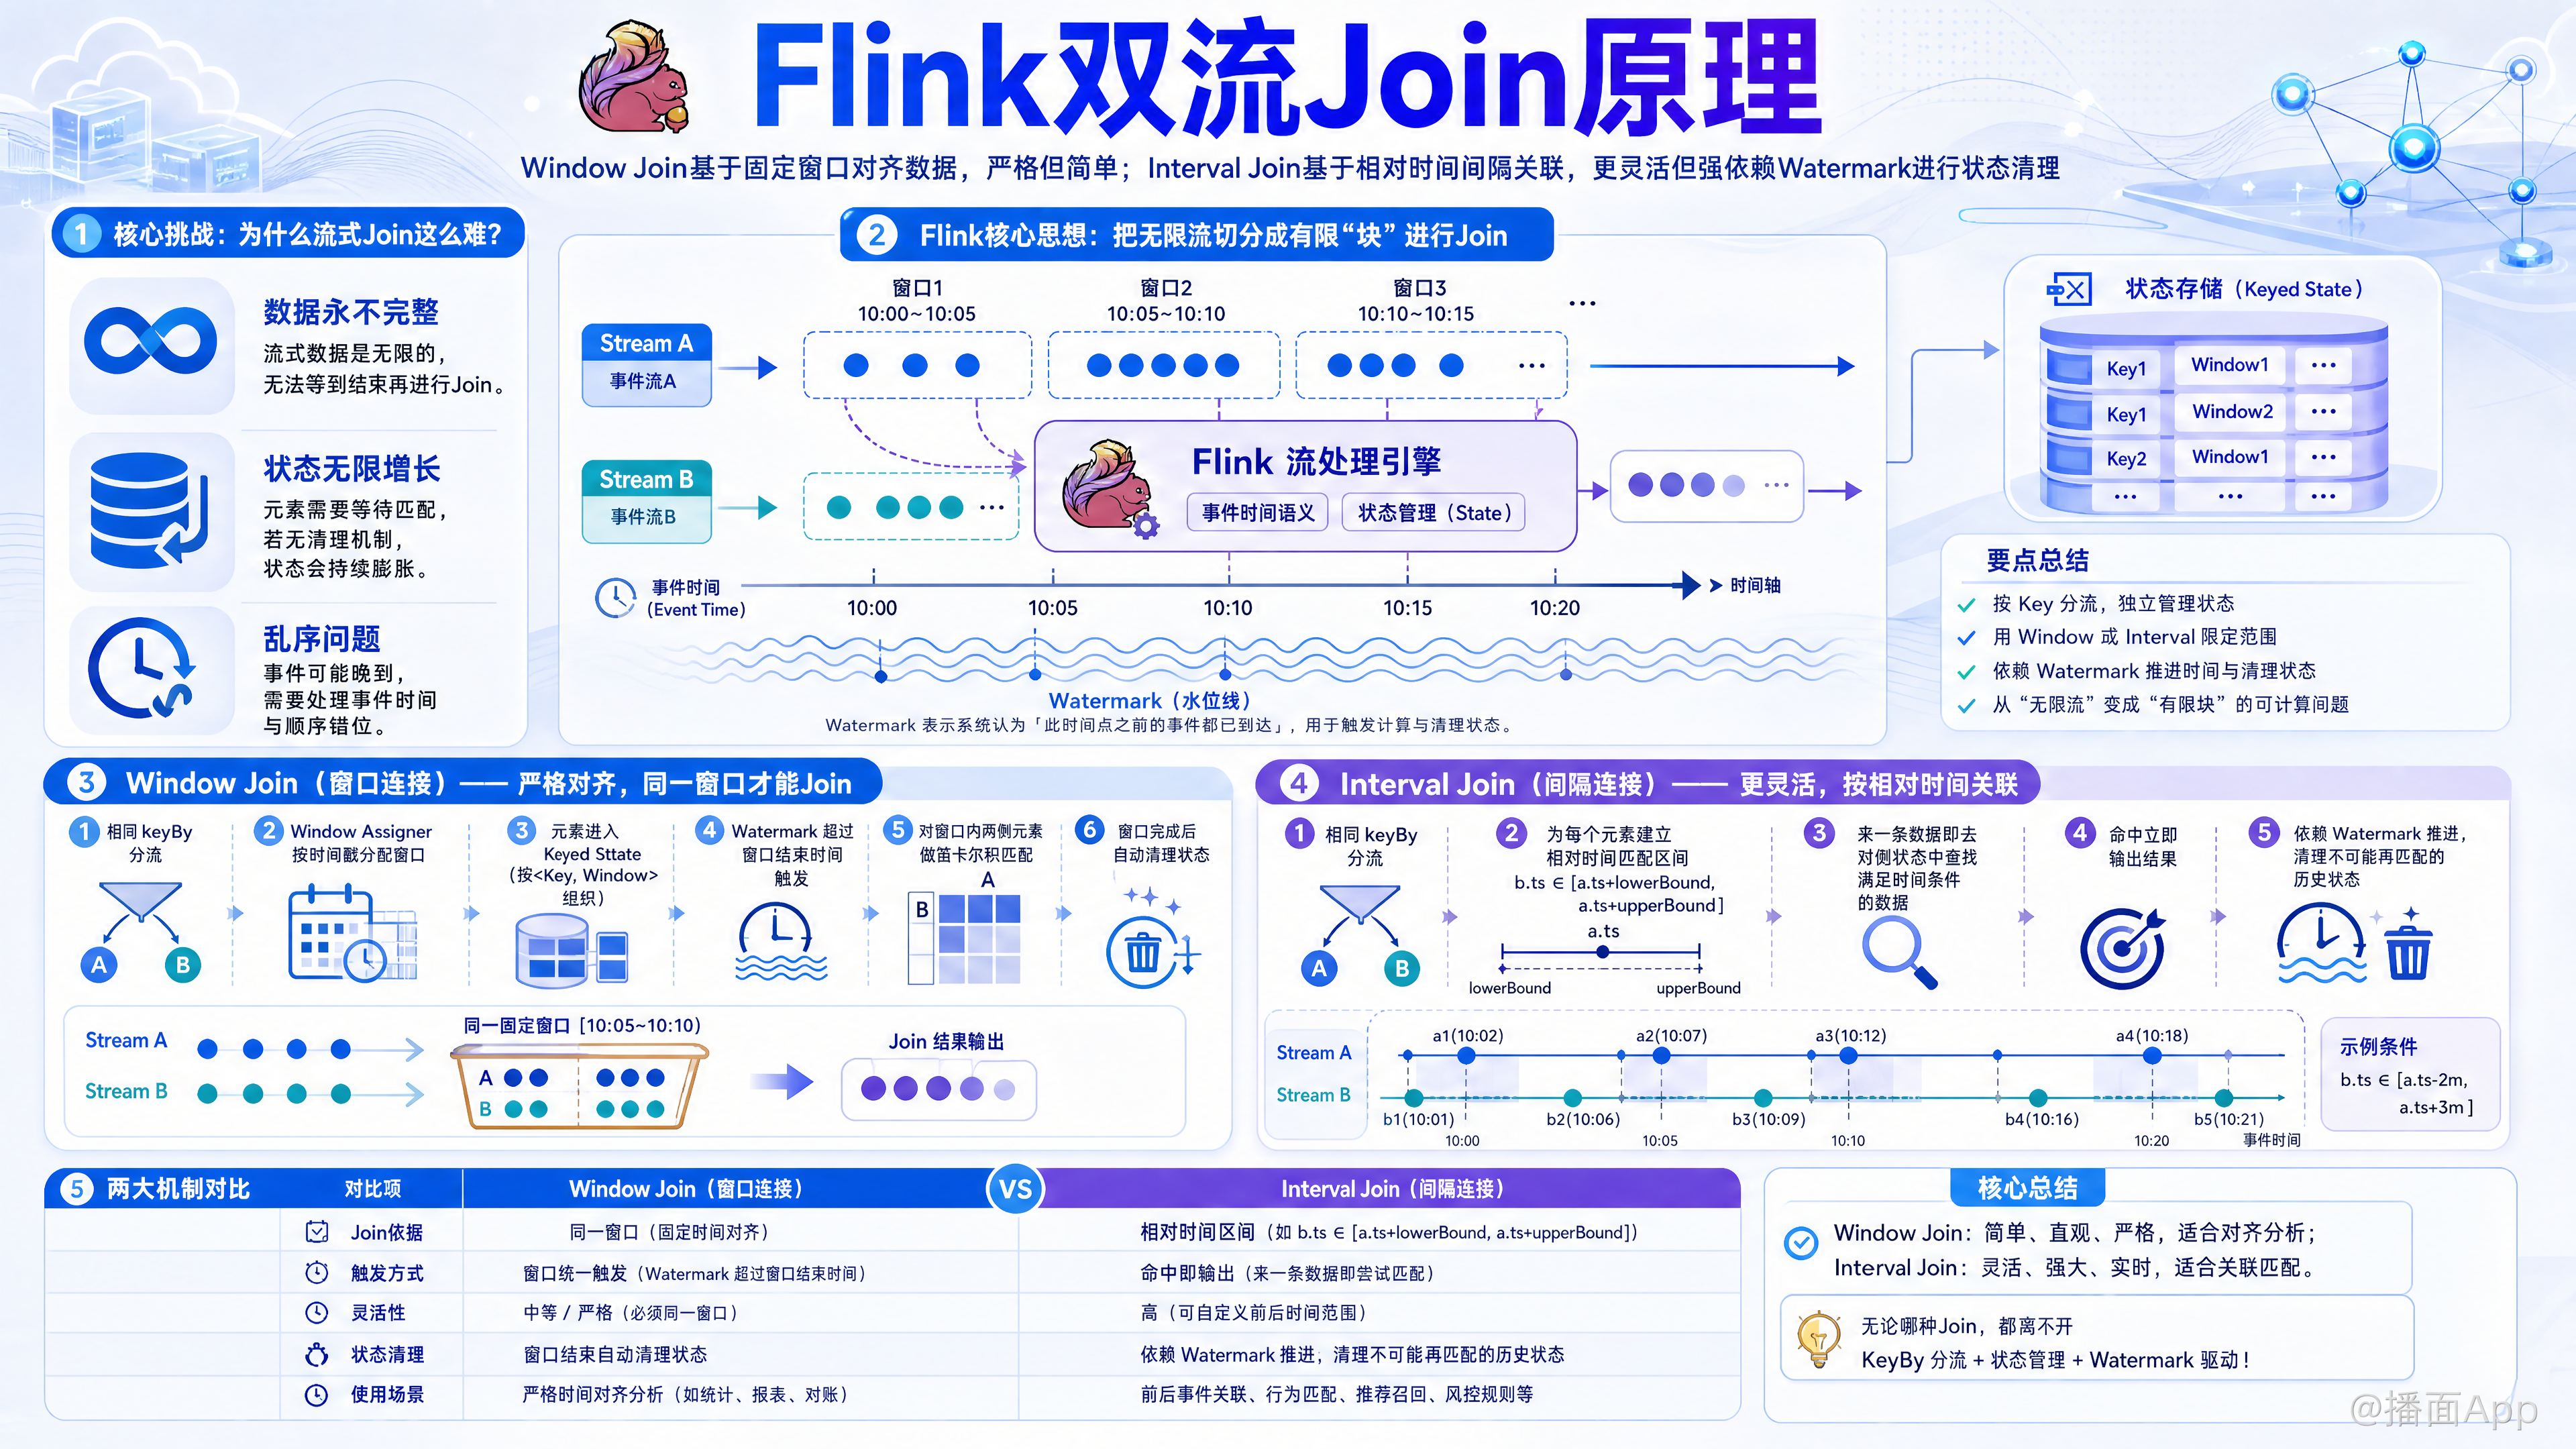
本文重点讲解Flink双流Join的两种核心机制:Window Join基于固定窗口对齐数据,严格但简单;Interval Join基于相对时间间隔关联,更灵活但强依赖Watermark进行状态清理
我们来深入、系统地讲解一下 Flink 双流 Join 的原理。
Flink 作为业界领先的流处理引擎,其双流 Join 功能非常强大,但理解其背后的原理对于正确使用和性能调优至关重要。
核心挑战:为什么流式 Join 这么难?
在传统的批处理(数据库)中,Join 操作是基于两个有限的数据集。引擎可以完整地看到两个数据集,然后进行匹配。
但在流处理中,数据流是无限(Unbounded)的。这意味着:
- 数据永不“完整”:你永远无法等到一个流结束后再与另一个流进行 Join,因为流永远不会结束。
- 状态无限增长:如果一个流中的某个元素要等待另一个流的匹配元素,它需要被存储起来。如果没有一个清理机制,那么随着时间的推移,存储的状态将无限增长,最终耗尽内存。
- 乱序问题:由于网络延迟等原因,事件可能不会按照其发生的顺序到达 Flink。一个本应先到的事件可能会后到。
为了解决这些问题,Flink 的核心思想是:将无限的流切分成有限的“块”进行 Join。这个“块”就是所谓的 窗口(Window) 或 时间间隔(Interval)。所有 Flink 的流式 Join 都离不开这个核心概念。
Flink 双流 Join 的两大实现方式
Flink 主要提供了两种内置的、基于时间的双流 Join 机制:Window Join (窗口连接) 和 Interval Join (间隔连接)。
1. Window Join (窗口连接)
(1) 原理
Window Join 的思想非常直观:只有当两个流中属于同一个窗口的元素才能被 Join。
想象一下两条并行的传送带(两个数据流),我们在它们上方设置了一个个固定大小的篮子(窗口)。只有同时掉入同一个篮子里的物品,我们才会把它们拿出来配对。
工作流程:
- 分流 (KeyBy):首先,必须对两个流使用相同的
keyBy()操作。这确保了拥有相同 key 的数据会被发送到同一个物理任务实例(Task Slot)上进行处理,这是 Join 的前提。 - 窗口分配 (Window Assigner):当数据元素到达时,Flink 会根据其时间戳(事件时间或处理时间)和窗口分配器(如滚动窗口、滑动窗口、会话窗口)将其分配到一个或多个窗口中。
- 状态存储 (State):每个流的元素在被分配到窗口后,并不会立即处理,而是被存储在 Flink 的keyed state(键控状态)中。这个 state 是以
<Key, Window>为单位进行组织的。例如,对于 key 为 "A",窗口为[10:00, 10:05)的数据,流1和流2的数据会分别被存放在各自的状态里。 - 窗口触发 (Trigger & Evictor):当窗口的触发条件满足时(例如,对于事件时间,当 Watermark 超过了窗口的结束时间),Flink 会执行 Join 操作。
- 执行 Join:触发时,Flink 会取出该窗口内属于流1的所有元素和属于流2的所有元素,然后对它们进行 笛卡尔积(Cartesian Product),即流1中的每个元素都会与流2中的每个元素进行匹配,并执行用户定义的
JoinFunction或ProcessWindowFunction。 - 状态清理:一旦窗口被触发并处理完毕,Flink 会自动清理该窗口对应的 state,从而解决了状态无限增长的问题。
(2) 适用场景
- 需要对齐在严格、固定时间段内的数据进行关联分析。
- 例如:计算每5分钟内,同一个用户的点击事件和曝光事件的数量。点击和曝光必须都发生在这5分钟的窗口内才能关联。
(3) 优缺点
- 优点:概念简单,易于理解。状态管理非常明确,窗口关闭即清理,状态大小可预测。
- 缺点:非常僵硬。如果一个事件的时间戳是
09:59:59,另一个是10:00:01,即使它们只相差2秒,但如果使用的是[09:55, 10:00)和[10:00, 10:05)这样的5分钟滚动窗口,它们将永远无法 Join。
2. Interval Join (间隔连接)
(1) 原理
Interval Join 提供了比 Window Join 更灵活的 Join 方式。它不要求元素必须在同一个“窗口”内,而是定义了一个相对的时间范围(Interval)。
其核心逻辑是:对于流1中的任意一个元素 e1,它可以和流2中时间戳在 [e1.timestamp - lowerBound, e1.timestamp + upperBound] 区间内的元素 e2 进行 Join。
工作流程:
- 分流 (KeyBy):与 Window Join 相同,必须先对两个流进行
keyBy()。 - 状态存储:
- 当流1(我们称之为左流)的一个元素
e1到达时,它会被存入其对应的 keyed state 中。 - 然后,Flink 会去检查流2(右流)的状态,查找所有时间戳满足
t2 ∈ [e1.timestamp - lowerBound, e1.timestamp + upperBound]的元素,并立即与e1进行 Join,输出结果。 - 当流2的一个元素
e2到达时,执行对称的操作:将其存入状态,并去检查流1的状态,查找所有时间戳满足t1 ∈ [e2.timestamp - lowerBound, e2.timestamp + upperBound]的元素,进行 Join 并输出。
- 当流1(我们称之为左流)的一个元素
- 状态清理(核心!):Interval Join 的状态清理机制是其精髓,它完全依赖于事件时间(Event Time)和 Watermark。
- 当 Watermark
W到达时,Flink 就知道所有时间戳< W的事件已经全部到达了。 - 对于左流中存储的一个元素
e1,它能匹配的右流元素的时间戳上限是e1.timestamp + upperBound。如果 WatermarkW已经超过了这个上限(即W > e1.timestamp + upperBound),就意味着不可能再有任何来自右流的元素能够与e1匹配了。 - 因此,Flink 可以安全地将元素
e1从状态中清除。 - 这个清理逻辑对两个流都适用。
- 当 Watermark
(2) 适用场景
- 需要关联发生在彼此附近的两个事件,而不关心它们是否落在同一个固定的窗口里。
- 例如:用户下单后(订单流),需要在下单前后5分钟内(支付流)找到对应的支付成功事件。一个订单在
10:02产生,它可以和09:57到10:07之间的任何支付事件关联。
(3) 优缺点
- 优点:非常灵活,更符合很多业务场景中“时间上相近”的关联需求。
- 缺点:
- 只能在事件时间(Event Time)上工作,并且强依赖于 Watermark 的正确性。
- 状态的大小取决于间隔(Interval)的长度和数据的到达速率,如果间隔设置得过大,可能会导致状态过大。
- 只支持
left.timestamp <= right.timestamp <= left.timestamp + bound和right.timestamp <= left.timestamp <= right.timestamp + bound这样的条件,不支持更复杂的关联条件。
原理总结与对比
| 特性 | Window Join (窗口连接) | Interval Join (间隔连接) |
|---|---|---|
| Join 条件 | 两个元素必须属于同一个窗口实例 | 一个元素的时间戳落在另一个元素时间戳的相对时间区间内 |
| 时间语义 | 支持处理时间(Processing Time)和事件时间(Event Time) | 仅支持事件时间(Event Time) |
| 灵活性 | 低,受窗口边界的严格限制 | 高,不受固定窗口边界的限制 |
| 状态清理机制 | 当窗口触发并结束时清理状态 | 当 Watermark 超过了元素可被 Join 的时间上界时清理 |
| 实现 | stream1.join(stream2).where(...).equalTo(...).window(...) |
stream1.keyBy(...).intervalJoin(stream2.keyBy(...)).between(...).process(...) |
| 核心数据结构 | 状态中通常使用 Map<Window, List<Element>> 类似结构 |
状态中通常使用 Map<Timestamp, List<Element>> 或有序的数据结构(如红黑树)来高效查询区间内的数据 |
| 典型用例 | 按小时/天对齐日志进行统计 | 订单和支付的关联,双十一大屏上广告点击与后续购买行为的实时关联 |